


Vielleicht kennst du das aus deiner Schulzeit – entweder hast du es selbst erlebt oder Freund:innen von dir: Man schreibt eine Mathe-Klausur und es kommt eine dieser Aufgaben, bei denen das Ergebnis schon nach drei Zeilen auf dem Notizblock steht. Trotzdem schreibt man nochmal zwei weitere Seiten voll – zur Sicherheit. Die Rechnung wird noch einmal von vorn aufgeschrieben, gegengeprüft, ein Alternativweg überlegt, ein möglicher Trick in der Aufgabenstellung ausgeschlossen. Am Ende steht dieselbe Zahl im Kästchen, die vorher schon am Rand stand.
In einer Klausur ist das vernünftig – Zwischenschritte geben meistens mehr Punkte. Für ein KI-System, das pro Tag tausende Anfragen beantworten soll, kann das unerwünscht sein.
Vor genau dieser Herausforderungen stehen Entwickler:innen moderner Reasoning-Modelle. Diese KI-Modelle erzeugen vor ihrer eigentlichen Antwort zusätzliche Zwischenschritte, um komplexe Aufgaben zu bearbeiten – quasi auf einer Art Notizblock. Das kann die Qualität der Antwort verbessern. Es kostet in der Regel aber auch Zeit, Rechenleistung und Tokens, verbessert aber nicht immer den Output.
Filip Sobczak aus dem KI-Team von QualityMinds beschäftigt sich mit der Frage, ob sich erkennen lässt, ab wann ein Modell in der Lage ist, eine korrekte Antwort zu geben. Könnte der Reasoning-Prozess an diesem Punkt kontrolliert beendet werden – ohne dass die Qualität darunter leidet?
Die erste Antwort aus seinen Experimenten ist überraschend deutlich: Bei einem Modell der 8-Milliarden-Parameter-Klasse entstehen auf einem Standard-Aufgabensatz drei Viertel der Gedankenkette erst, nachdem die richtige Antwort bereits abrufbar war. Bildlich gesprochen: drei Viertel des “Notizblocks” werden überflüssigerweise vollgeschrieben.
Warum ist Reasoning überhaupt nützlich?
Frühe Sprachmodelle versuchten häufig, eine Frage möglichst direkt zu beantworten. Bei einfachen Aufgaben funktionierte das oft erstaunlich gut. Sobald jedoch mehrere Schritte nötig waren – etwa bei logischen Problemstellungen – stieg die Gefahr, dass das Modell vorschnell zu einem falschen Ergebnis kam.
Ein einfaches Beispiel zeigt das Prinzip: „Markus hat zehn Äpfel. Er gibt die Hälfte davon ab und isst anschließend zwei weitere. Wie viele Äpfel hat Markus?“ Um auf die richtige Antwort zu kommen, müssen zwei Schritte nacheinander ausgeführt werden: zuerst zehn durch zwei teilen, danach zwei abziehen. Es bleiben drei Äpfel.
Menschen führen solche Zwischenschritte meist selbstverständlich aus. Sprachmodelle mussten dazu zunächst ausdrücklich angeleitet werden. Eine Zeit lang genügte oft schon der Prompt-Hinweis „Denke Schritt für Schritt“, um einen besseren Output zu erhalten. Diese Form des Promptings wurde als Chain-of-Thought-Prompting bekannt.
Heute sind moderne Reasoning-Modelle darauf trainiert, bei komplexeren Aufgaben selbst zusätzliche Zwischenschritte zu erzeugen, bevor sie ihre endgültige Antwort formulieren. „Reasoning“ bezeichnet dabei den umfassenderen Vorgang, eine Aufgabe über mehrere Schritte hinweg zu bearbeiten. Die Chain of Thought – oder der Reasoning Trace – ist die sprachlich erzeugte Folge dieser Zwischenschritte.
Man kann sie sich wie einen Notizblock in der erwähnten Mathe-Klausur vorstellen: einen Scratchpad, auf dem das Modell Zwischenergebnisse festhält, Annahmen prüft oder verschiedene Lösungswege vergleicht. Dieser zusätzliche Raum kann helfen, komplexe Aufgaben strukturierter zu bearbeiten – etwa in Mathematik, Programmierung, Planung oder bei mehrstufigen Analysen.
Wichtig ist dabei: Dieser Notizblock ist nicht das „Denken“ eines KI-Modells. Was dort sprachlich erscheint, ist kein exaktes Abbild aller internen Berechnungen, sondern der Output von Zwischenüberlegungen. Auf diesen Unterschied kommen wir später zurück – er ist für die eigentliche Frage entscheidend.
Mehr Reasoning ist nicht automatisch besser!
Die Einführung zusätzlicher Reasoning-Schritte hatte einen guten Grund: Wer eine schwierige Aufgabe in mehrere einfache Teilschritte zerlegt, muss an keiner Stelle die Lösung auf einmal finden – und kann sozusagen unterwegs zusätzlich Rechenfehler entdecken oder Annahmen hinterfragen.
Aber: In Reasoning Traces lässt sich beobachten, dass Modelle mitunter dieselben Argumente wiederholen, bereits gefundene Ergebnisse erneut überprüfen oder parallele Lösungswege verfolgen, die am Ende zum gleichen Resultat führen.
Wie teuer das ist, lässt sich messen. GSM8K, einer der Standard-Datensätze für solche Tests, besteht aus Textaufgaben auf Grundschulniveau mit typischerweise zwei bis vier Rechenschritten. Ein Modell der 8-Milliarden-Klasse verbraucht dafür im Median 1836 Tokens pro Antwort. Das sind rund 1 100 Wörter für eine Aufgabe, deren Lösungsweg in zwei Zeilen passt. Konkret: Für die Aufgabe „Es treffen sich 20 Freunde, jeder bekommt 4 Pizzastücke, eine Pizza hat 8 Stücke – wie viele Pizzen müssen sie bestellen?“ erzeugt dasselbe Modell 1659 Tokens.
Bei den schwereren Aufgaben eines Mathematik-Wettbewerbsdatensatzes liegt der Median bei rund 3700 Tokens, und ein Teil der Antworten stößt an das eingestellte Limit von 8192 Tokens, ohne die Bearbeitung abschließen zu können. Beim kleinsten getesteten Modell betrifft das dort fast ein Viertel aller Anfragen. Dieser Abbruch ist natürlich unerwünscht: volle Kosten, aber kein Ergebnis.
In der Forschung wird für dieses Muster gelegentlich der Begriff „Overthinking“ verwendet. Gemeint ist kein menschliches Grübeln, sondern ein ineffizienter Reasoning-Prozess: Das Modell erzeugt weitere Zwischenschritte, ohne dass sich die Qualität der finalen Antwort verbessert.
Genau hier liegt aber die Schwierigkeit. Würde man den Prozess einfach unkontrolliert früher abbrechen, könnte das Modell eine wichtige Selbstkorrektur verpassen. Vielleicht entdeckt es erst im nächsten Schritt einen Widerspruch oder erkennt, dass eine erste Lösung falsch war.
Das Ziel ist also nicht, den Reasoning-Prozess so kurz wie möglich zu halten. Gesucht wird ein Punkt, an dem das Modell bereits zuverlässig antworten kann und weiteres Reasoning keinen Zusatznutzen mehr bringt.
Wie man den early-Exit findet
Um diesen Punkt zu finden, geht man experimentell vor – es wird der Ausstieg erzwungen. Das Modell löst eine Aufgabe zunächst vollständig; betrachtet werden nur die Aufgaben, die es dabei richtig gelöst hat. Dann wird seine Gedankenkette auf dem Notizbuch vom Ende her Satz für Satz gekürzt – und nach jeder Kürzung muss es sofort antworten, ohne weiterdenken zu dürfen. Der letzte Schnitt, bei dem die Antwort noch stimmt, markiert die Grenze: den frühesten Punkt, an dem ein vorzeitiger Ausstieg noch die richtige Antwort liefert.
Getrennt davon wird festgehalten, in welchem Satz die richtige Antwort erstmals im Text des Notizblocks auftaucht.
Damit gibt es zwei Marken in derselben Gedankenkette: die Stelle, ab der ein Ausstieg funktioniert, und die Stelle, an der die Antwort ausgeschrieben dasteht. Läge die erste Marke hinter der zweiten, wäre das Ergebnis wenig überraschend – das Modell könnte dann einfach ablesen, was es bereits in den Notizblock geschrieben hat. Interessant ist der umgekehrte Fall: Der Ausstieg funktioniert schon, obwohl die Antwort im Text noch gar nicht vorkommt. Dann hat das Modell sie berechnet, ohne sie aufzuschreiben. Und genau dieser Vorlauf ist der Spielraum, den ein Early Exit nutzen könnte.
Ein Beispiel
Wie das konkret aussieht, zeigt ein einzelner Trace aus dem Datensatz. Die Aufgabe: John möchte Pizzen bestellen, sodass jeder seiner 20 Freunde vier Stücke bekommt; eine Pizza hat acht Stücke. Die richtige Antwort ist: John muss 10 Pizzen bestellen.
Der Trace des kleinen Modells hat 27 Sätze. Die Grenze für einen erfolgreichen Early-Exit liegt bei Satz 5. Die Antwort „10“ fällt zum ersten Mal in Satz 13.
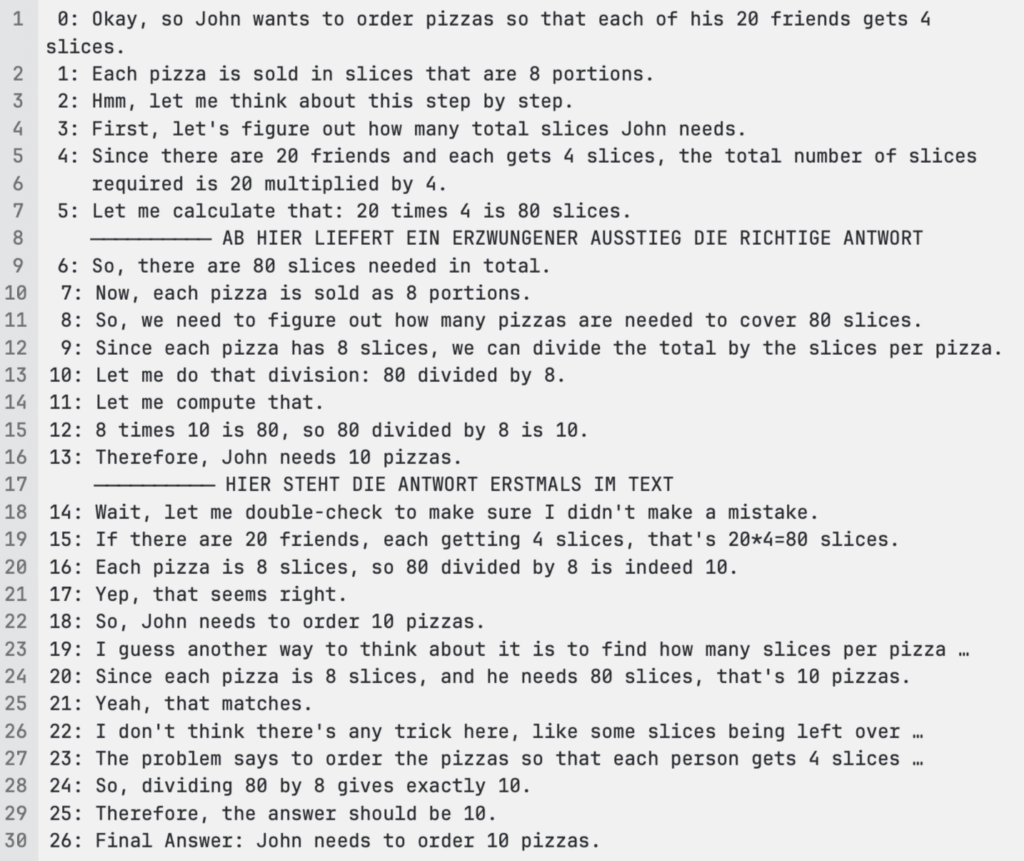
Zwei Dinge sind hier gleichzeitig zu sehen. Ab Satz 5 – das Modell hat gerade 80 Stücke berechnet, die Division steht noch nicht da – liefert ein erzwungener Ausstieg zuverlässig die Antwort 10 Pizzen. Die Rechnung 80 ÷ 8 findet also statt, ohne aufgeschrieben zu werden. Und ab Satz 14 passiert nichts Neues mehr: dieselbe Rechnung, dreimal wiederholt, in leicht anderer Formulierung, mit demselben Ergebnis. Das ist die Hälfte des Traces!
Was dabei herauskommt
Getestet wurden drei Modellgrößen der Qwen3-Familie auf zwei Aufgabensätzen: Grundschul-Textaufgaben (GSM8K) und schwereren Wettbewerbsaufgaben (MATH).
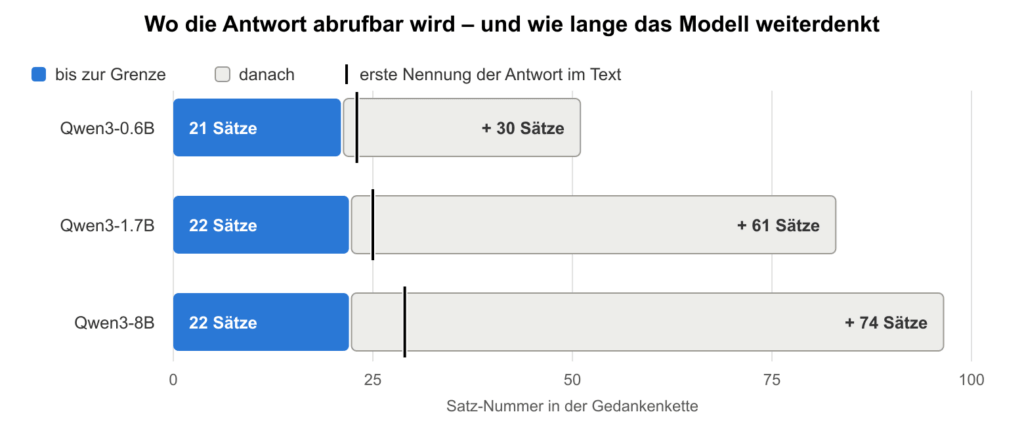
Erste Erkenntnis: Der größere Teil des Reasonings entsteht nach der ermittelten Grenze.
Beim größten getesteten Modell liegt die Grenze bei den Grundschulaufgaben im Median bei Satz 22 – von im Median 96 Sätzen. Rund drei Viertel der Gedankenkette entstehen also, nachdem die richtige Antwort schon abrufbar war.
Dabei fällt ein Muster auf, das für alle drei Modellgrößen gilt: Die Grenze liegt überall bei Satz 21 bis 22. Die Gedankenketten werden dagegen fast doppelt so lang – von 51 bis hin zu 96 Sätzen. Das größere Modell denkt also nicht länger, bis es die Antwort hat. Es denkt länger, nachdem es sie hat.
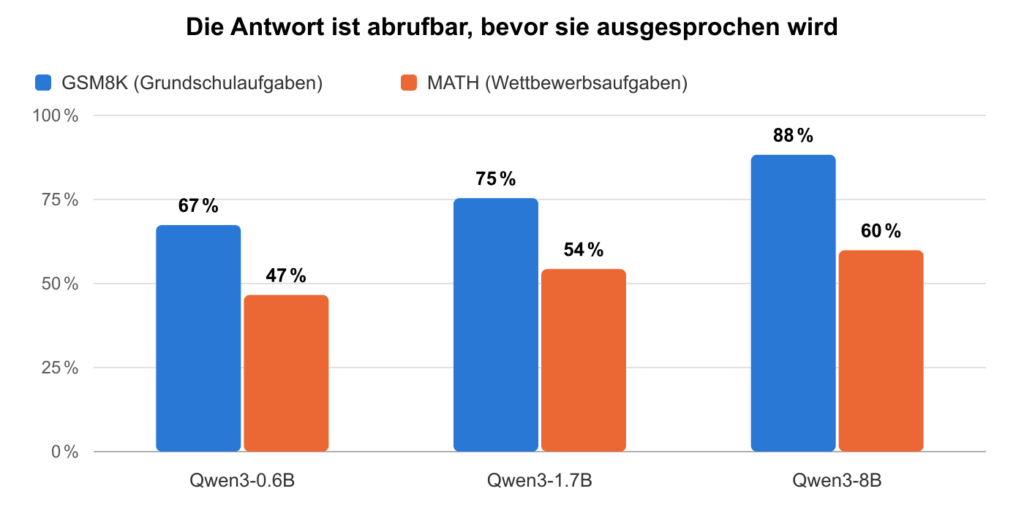
Zweite Erkenntnis: Die Antwort ist meist abrufbar, bevor sie ausgesprochen wird.
Bei den Grundschulaufgaben liegt die Grenze in zwei Dritteln bis fast neun Zehnteln der Fälle vor dem Satz, in dem die Antwort erstmals im Text steht – und der Anteil steigt mit der Modellgröße. Bei den schwereren Wettbewerbsaufgaben ist es nur noch etwa jede zweite Aufgabe.
Dritte Erkenntnis: Ein Teil der Aufgaben braucht überhaupt kein Reasoning.
Löscht man die Gedankenkette komplett und verlangt direkt eine Antwort, liegt das größte Modell bei fast jeder zehnten Grundschulaufgabe und fast jeder siebten Wettbewerbsaufgabe trotzdem richtig. Es erzeugt die Gedankenkette also auch dort, wo sie keinen Mehrwert bringt, einfach weil es darauf trainiert ist, nicht weil die Aufgabe es verlangt.
Und diese Erkenntnis ist zugleich das stärkste Argument gegen die naheliegende Abkürzung, einfach das Token-Budget pro Bearbeitung zu halbieren: Ein zielführendes Reasoning-Budget ist nicht kurz, es ist aufgabenabhängig.
Berechnet, aber nicht ausgesprochen
Das führt zu einer wichtigen Präzisierung. „Die Antwort ist abrufbar“ heißt hier genau: Wer an dieser Stelle abschneidet und eine Antwort verlangt, bekommt die richtige. Es heißt nicht, dass das Modell die Antwort „weiß“ oder sie irgendwo notiert hätte.
Du kannst einen kleinen Selbstversuch machen: Sage dir „sieben mal acht“ – die 56 war vermutlich da, bevor du sie ausgesprochen hast. Das Sprechen hinkt bei uns Menschen häufig dem Rechnen hinterher. Etwas Ähnliches passiert auch in Sprachmodell: Die relevante Information ist noch nicht ausgesprochen, aber bereits berechnet. Forschende sprechen hier von „Faithfulness“: Eine plausibel klingende Antwort ist nicht automatisch ein getreues Abbild der internen Berechnungen eines Sprachmodells.
Für die Ausgangsfrage hat das eine unmittelbare Konsequenz: Wenn die korrekte Antwort abrufbar ist (z.B. 10 Pizzen), ohne dass sie zuvor im Text des Notizblocks stand, ist dieser Punkt in der Gedankenkette nicht einfach erkennbar. Wer den Ausstiegspunkt / Early Exit finden will, muss dort messen, wo er entsteht – in den internen Zuständen des Modells.
Gibt es ein inneres Signal?
Genau das ist der nächste Schritt für Filip. Für tausende Aufgaben ist inzwischen bekannt, wo die Grenze liegt – man kann also vergleichen, wie die internen Zustände des Modells kurz davor und kurz danach aussehen. Gesucht ist dabei nicht die jeweilige Lösung, die von Aufgabe zu Aufgabe anders lautet, sondern ein wiederkehrendes Muster, das den Übergang markiert.
Ein weiterer Vergleich kann hier hilfreich sein: Man hört in der Regel, dass Wasser kocht, bevor man es sieht. Die Frage ist, ob es im Modell ein vergleichbares Signal gibt.
Ein erster, absichtlich einfacher Test hilft bei der Näherung an dieses Muster: Er trifft in etwa drei von vier Fällen die richtige Einschätzung – und zwar auch bei Aufgaben, die er vorher nie gesehen hat. Am deutlichsten ist das Signal in der Mitte des künstlichen neuronalen Netzes, zum Ausgang hin wird es schwächer. Es findet sich damit gerade nicht in dem Teil des Sprachmodells, der die jeweils nächsten Wörter formuliert. Das passt zum vorhin dargestellten Befund: Das gesuchte Signal ist etwas anderes als der Text im Notizblock.
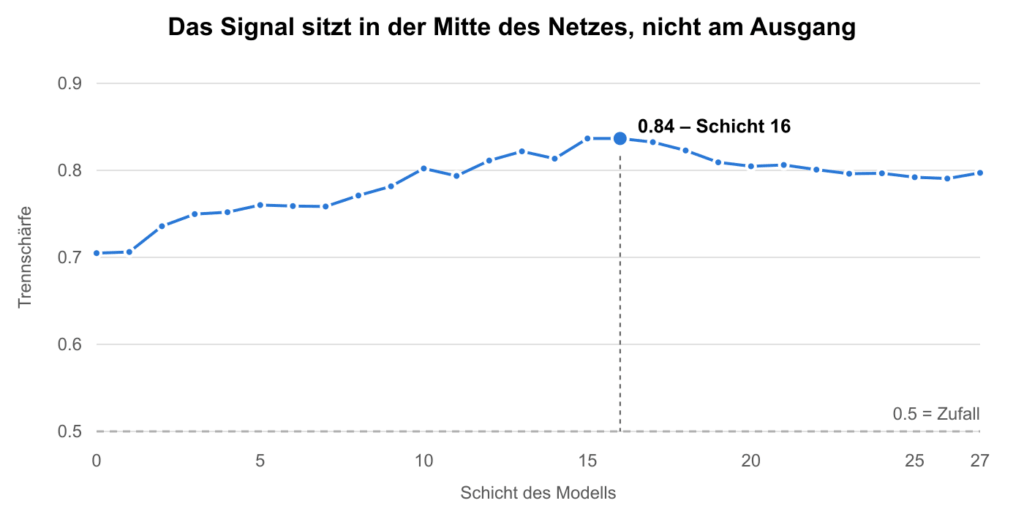
Das heißt nicht, dass man hier schon den Early Exit setzen sollte. Bei jeder vierten Fehlentscheidung wäre der Preis zu hoch. Es ist aber der Beleg, dass an dieser Stelle überhaupt etwas zu messen ist – und die Grundlage für die nächste Stufe.
Zwei wege zum kontrollierten Early Exit
Daraus ergeben sich zwei Wege, einen Reasoning-Prozess früher zu beenden.
Der erste Weg überwacht den laufenden Prozess von außen. Eine zusätzliche Komponente prüft nach jedem Abschnitt, ob der interne Zustand auf Antwortbereitschaft hindeutet, und stoppt das Reasoning, sobald das Signal erkennbar ist. Aus Qualitätssicht wiegt ein Vorteil hier schwer: Dieser Weg ist testbar, messbar und abschaltbar. Sein Nachteil: Die Überwachung kostet selbst Rechenzeit und muss schnell genug sein, damit der Effizienzvorteil einer vorzeitig beendeten Gedankenkette nicht wieder aufgezehrt wird.
Der zweite Weg setzt früher an: beim Training. Üblicherweise wird ein Modell erst belohnt, nachdem es eine Aufgabe vollständig bearbeitet hat; ob die Lösung schon deutlich früher erreichbar gewesen wäre, spielt dabei keine Rolle. Ein längenbewusstes Training könnte das künftig ändern – etwa indem die höchste Belohnung dort vergeben wird, wo eine korrekte Antwort zum ersten Mal möglich ist. Das ist eleganter, weil der Mechanismus nicht um das Modell herum gebaut wird: Es lernt selbst, seine Reasoning-Länge an der Aufgabe auszurichten. Es ist aber auch teurer, und das Ergebnis ist ein Verhalten, das sich nicht mehr abschalten lässt, sondern grundsätzlich neu evaluiert werden muss.
Zu beiden Wegen gibt es erste Arbeiten – etwa Antwortkonvergenz als Stoppsignal für den ersten und S-GRPO für den zweiten.
Was Unternehmen davon haben
Für Unternehmen ist die Frage nach effizienterem Reasoning nicht akademisch. Jeder zusätzliche Reasoning-Schritt kostet Zeit, Tokens und Rechenleistung. Bei einzelnen Anfragen fällt das kaum ins Gewicht. In Anwendungen mit vielen tausenden Modellaufrufen pro Tag und einer auf Token-Verbrauch basierten Abrechnung wird daraus allerdings ein relevanter Kosten- und Leistungsfaktor.
Das betrifft KI-Assistenten, Codegenerierung, automatisierte Test- und Analyseprozesse oder agentische Systeme, in denen viele Modellaufrufe aufeinander folgen. Gerade dort vervielfacht sich unnötig langes Reasoning.
Ein kontrollierter Early Exit bringt in solchen Szenarien geringere Antwortzeiten, weniger Tokens, niedrigere Kosten und einen höheren Durchsatz – bei selbst gehosteten Modellen mit begrenzten GPU-Ressourcen besonders deutlich spürbar. Und Latenz ist nicht nur eine technische Kennzahl: Ein System, das zuverlässig in wenigen Sekunden antwortet, wird anders wahrgenommen als eines, das für dieselbe Qualität deutlich länger braucht.
Trotzdem wäre es zu kurz gegriffen, nur die Kosten pro Anfrage zu betrachten. Entscheidend sind Kosten und Latenz pro zuverlässiger Antwort. Ein Kuchen ist fertig, wenn er fertig ist – nicht wenn der Timer klingelt. Der Zahnstocher misst den Zustand statt die Zeit; und wer zu früh aufhört, hat nicht schneller einen Kuchen, sondern einen ungenießbaren.
Das ist der Unterschied zwischen einem gekürzten Token-Budget und einem kontrollierten Early Exit: Ein Modell, das früh stoppt und dabei häufiger falsch liegt, ist nicht effizient – es verlagert die Kosten nur in Nachfragen, Korrekturen und manuelle Prüfungen. Der wirtschaftliche Nutzen entsteht erst, wenn ein Verfahren den Rechenaufwand senkt und die notwendige Qualität erhält.
Wo quality Engineering beginnt
Deshalb braucht ein Early-Exit-Mechanismus klare Qualitätskriterien: den Anteil korrekter Antworten, die Anzahl der Tokens pro erfolgreich gelöster Aufgabe, die End-to-End-Latenz sowie das Verhältnis von früheren zu unnötig späten Abbrüchen.
Ebenso wichtig ist die Robustheit. Funktioniert das Stoppsignal auch bei leicht veränderten Prompts? Bleibt es bei schwierigeren oder unbekannten Aufgaben zuverlässig? Verändert sich sein Verhalten nach einem Modellupdate?
Dass diese Fragen nicht rhetorisch sind, zeigen die Ergebnisse selbst: Zwischen Grundschulaufgaben und Wettbewerbsmathematik halbiert sich beinahe der Anteil der Fälle, in denen überhaupt Einsparpotenzial im Reasoning steckt. Ein Verfahren, das auf dem einen Aufgabensatz gut funktioniert, ist auf dem anderen nicht automatisch brauchbar.
Ein weitere wichtiger Punkt: Bisher lassen sich Grenze und Signal finden – es gab aber noch keinen Lauf, in dem ein Modell tatsächlich vorzeitig gestoppt hat. Die Effizienzgewinne stellen ein Potenzial dar, sind aber noch nicht gemessenes Ergebnis. Die Messungen selbst sind dabei vorsichtig angelegt: Gekürzt wird nur bis zum ersten Fehlschlag, der wirklich früheste Ausstiegspunkt kann also noch früher liegen.
Beantworten lassen sich solche Fragen nicht ein für allemal: Produktive KI-Systeme brauchen daher wiederkehrende Evaluation, Monitoring und gezielte Tests kritischer Fälle – gerade dann, wenn Modelle aktualisiert oder in neue Anwendungskontexte übertragen werden.
Genau hier verbindet sich Filips Forschung mit dem Anspruch von QualityMinds: Effizienz und Qualität werden nicht gegeneinander ausgespielt. Eine technische Optimierung wird als testbare Systementscheidung verstanden, die unter realistischen Bedingungen validiert werden muss.
KI-Systeme effizienter und zuverlässiger machen
Wie viel Potenzial steckt in deinen KI-Systemen – und wo entstehen unnötige Kosten, Latenzen oder Qualitätsrisiken? Im QualityMinds AI Lab beschäftigen wir uns genau mit solchen Fragen: Wir untersuchen neue KI-Technologien, entwickeln und erproben Ansätze rund um AI Quality Engineering.
Du möchtest einen eigenen KI-Use-Case evaluieren, etwas ganz Neues ausprobieren oder dich smit uns über aktuelle Entwicklungen austauschen?
Besuche unser AI Lab unter ai.qualityminds.com oder erfahre mehr über QualityMinds unter www.qualityminds.com.


Schreib uns eine Mail – wir freuen uns auf deine Nachricht! hello@qualityminds.de oder auf LinkedIn
- Zwei Kurven voraus: Was Rallyesport über moderne Führung verrät – Eine fünfteilige Serie über Führung, Vertrauen und Zusammenarbeit. Teil 5.
- Zwei Kurven voraus: Was Rallyesport über moderne Führung verrät – Eine fünfteilige Serie über Führung, Vertrauen und Zusammenarbeit. Teil 4.
- Zwei Kurven voraus: Was Rallyesport über moderne Führung verrät — Eine fünfteilige Serie über Führung, Vertrauen und Zusammenarbeit. Teil 3.